录音转文字,教你三个最简单的办法
先说结论。
开会、听课、听讲座,录了音,怎么变成文字?这半年我试了不少工具,最后留下三个,都是上手就能用的:
一,通义听悟网页版。免费,文件传上去就行。
二,录音卡片自带的转写。录完自动出字。
三,家里的机器本地跑。材料不出门。
前两个五分钟上手,免费额度对大多数人够用。第三个要一台像样的机器,但我把配置直接给你,复制给你的 AI 就能装。
怎么选就一句:公开的讲座、课程、会议,前两个随便用;涉及客户、案子、公司内部的,只走第三个。
还有一句:不管走哪条,出来的都是初稿。把初稿丢给你自己的 AI,补上背景让它洗一遍,才是能用的稿。
公开的走云端 涉案的用本地
01 · 上周五,五个多小时的录音
先说我自己的场景。上周五外滩大会我录了两场,一场三个半小时,一场两个多小时。回到家把两个文件丢给家里的机器,睡觉。第二天早上,两份带时间戳、带说话人标签的文字稿已经在那儿了。
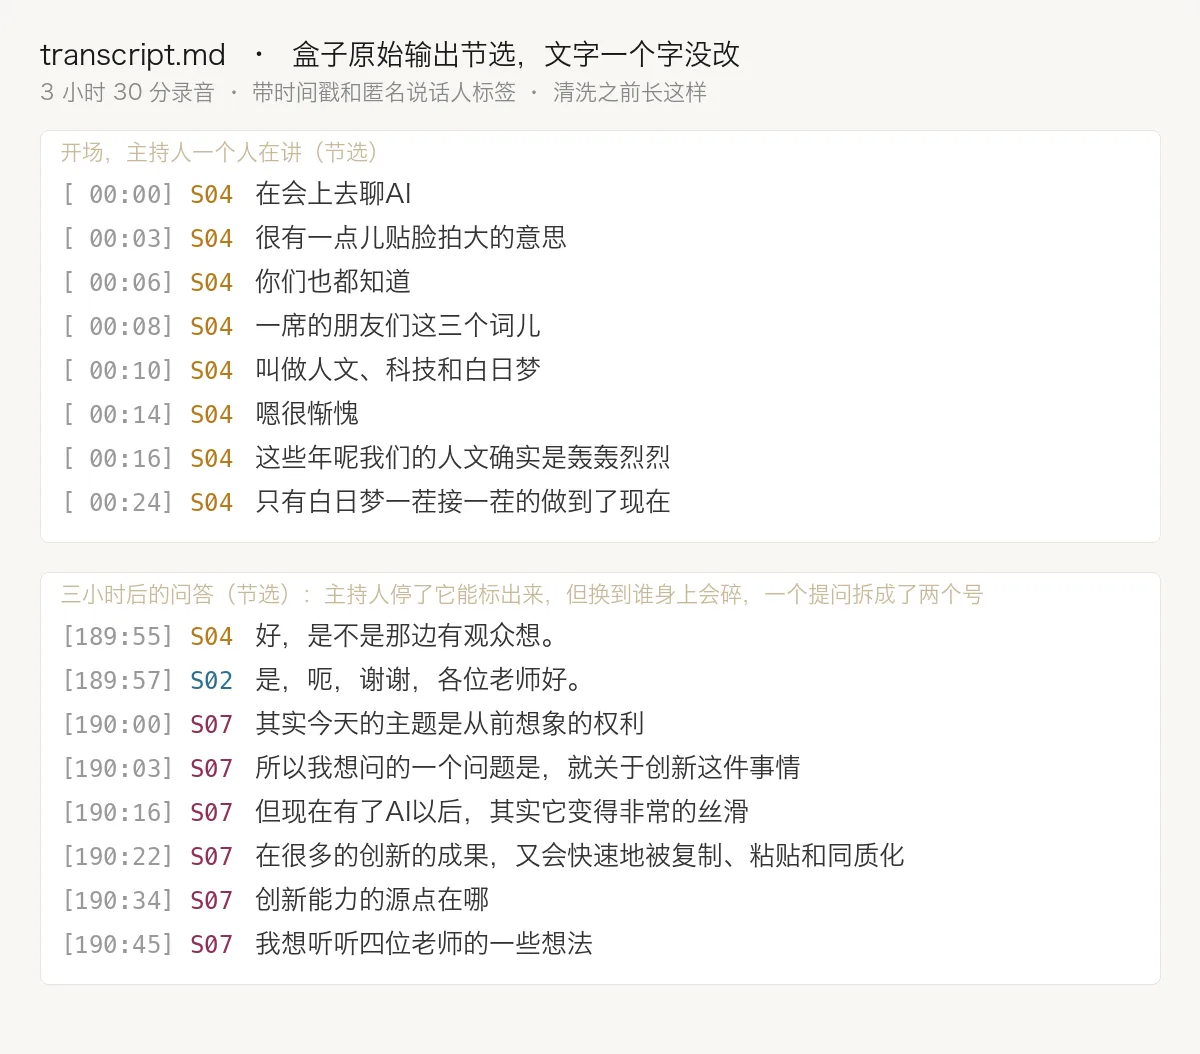
盒子转出来的原始稿,节选,没清洗。主持人开场是 S04;三小时后的问答,主持人停下它能标出来,但换到谁身上会碎,一个提问被拆成了两个号
后面那篇文章、这篇文章,都是对着这份稿子写的。
但这条路我是 9 月才走通的。之前一直用前两个,到今天也还在用。三个都是亲手试过、留下来的。
02 · 三个方法,各怎么用
路一:通义听悟。适合不想装任何东西的人。
网页版登录,点「上传音视频」,文件拖进去。单个文件最长 6 小时、500MB,上传时可以选区分发言人:单人演讲、2 人对话、多人讨论。等几分钟,稿子出来,带时间戳,能导出。
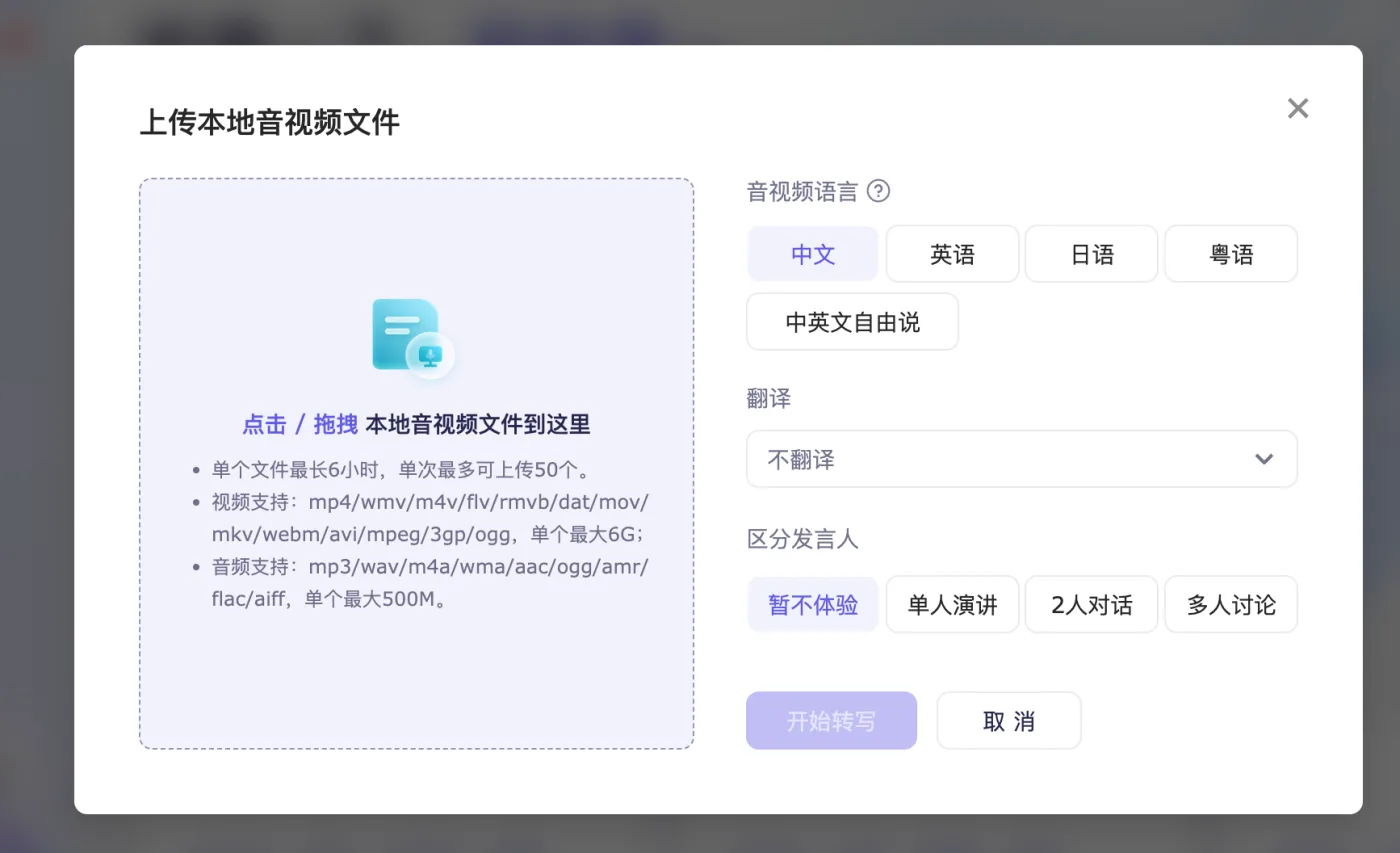
通义听悟的上传框,能选区分发言人
额度是这样的:每天登录一次送 10 小时转写时长,能攒到 400 小时。正常人用不完。
坑只有一个:文件在阿里的服务器上转。公开讲座无所谓,涉案的谨慎传。
路二:录音卡片自带的转写额度。适合本来就带着卡片的人。
6 月我写过为什么随身带一块录音卡片,那篇讲的是录。这里补的是转:我用的卡片是钉钉 A1,配套的手机软件就是钉钉,里面的功能叫 AI 听记。录完自动传过去,在免费额度里直接转,不用倒腾文件。外滩那场三个半小时,App 里就是一份带发言人的转写稿加一份 AI 纪要。
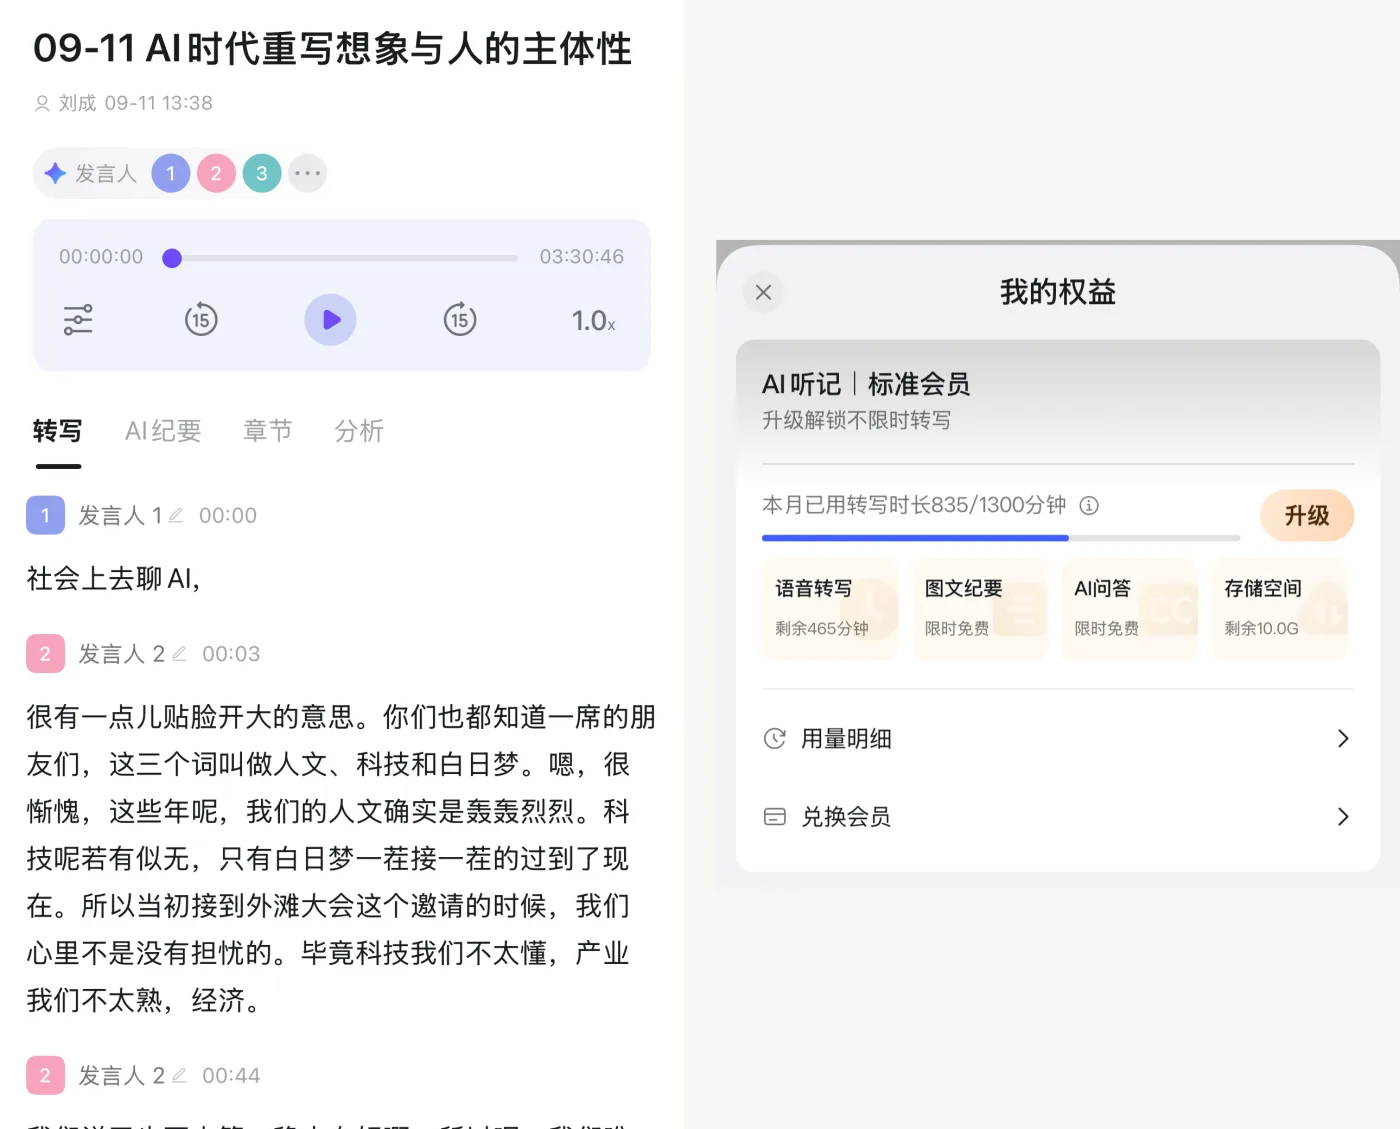
钉钉 AI 听记的转写页,和本月 1300 分钟额度
当初选它,最主要的一条就是免费转写额度高:每个月 1300 分钟。各家卡片给的额度差很多,有的多有的少。我买卡片就是为了要文字,所以额度是第一位的,别的功能都在后面。
同样,也是云端转的。额度用完了,我就切到第三条。
路三:家里的机器本地跑。适合材料不能出门的场合,或者前两条额度用完的时候。
先说丑话:这条吃硬件。我自己用的硬件是 DGX Spark,一小时录音处理完差不多 6 分钟,给大家做个参考。
8 月底我写过脱敏那篇,结论是材料出门这件事本身就是问题,所以家里放了一台机器跑模型。录音转文字是它干的活里最顺手的一个。
选哪个模型,我试了几个。
FunASR 最快,55 分钟的录音 45 秒出字,但句子是碎的,「案件」听成「按键」,说话人只能分出两个。搜个词可以,出稿不行。
VibeVoice 7B 短片段质量很好,长录音跑到中间会陷进一句话反复循环,内存也吃得多。
Qwen3-ASR 英文词略好,中文关键词错得多,而且不分说话人。
最后定的是复旦开源的 MOSS-Transcribe-Diarize。一次推理同时出文字、说话人、时间戳,支持热词,中文口语和法律词(请求权基础、类案检索)整段就很准。模型只有 1.8GB。
英文名词是它的短板,DeepSeek 会写成 DIPSICK。解决办法是把长录音切成 10 分钟一段,每段带上热词,再用一个声纹模型把各段的说话人对齐回去。这一套是踩了几个坑之后定下来的,参数都在下面。
说话人分离要说句实话:几个人轮流上台演讲的场合,它会把三个讲者并成一个标签,零星插话又会碎成好几个号。这次外滩那份稿子,我是按主持人过场的时间点重新标的人。两个人对谈、开会这种它就很稳。
最快的不是最好的 一次出全的才省事
03 · 本地那条的部署指令,复制给你的 AI
硬件要求:一台正常的电脑就行。有 NVIDIA 显卡最好;Mac 的 M 系列芯片也能跑;都没有就用 CPU 跑小一点的模型,慢一些。转写服务可以装在你正在用的这台电脑上,也可以装在家里另一台机器上,Mac mini、Mac Studio、带显卡的台式机都行。下面的指令让 AI 先判断你是哪种情况,再往下装。
带 NVIDIA 显卡那条是我实测过的,参数照抄就行。Mac 和纯 CPU 那两条是让 AI 按顺序试的路线,跑不动就退一档。
下面这段复制给你的 AI 助手,让它照着做。
部署指令 · 整段复制给你的 AI
【任务】帮我在本地部署一个语音转文字服务,要带说话人区分和时间戳,中文优先,长录音(3 小时以上)要能跑。先判断我的情况,再选路线,不要一上来就装。

【第一步,判断设备】先检查并告诉我:
1. 我现在是只有这一台电脑(你和转写服务在同一台机器上),还是另有一台单独的机器(Mac mini、Mac Studio、带显卡的台式机、DGX 这类)专门用来跑?
2. 这台要跑转写的机器是什么硬件:有没有 NVIDIA 显卡(显存多大)、是不是 Apple M 系列芯片、还是只有 CPU?内存多大?
按结果走下面对应的路线。

【路线 A:有 NVIDIA 显卡,显存 16GB 以上(12GB 也行,把 KV 降到 6GiB)】这是我实测过的配置,参数照抄。
- 模型:OpenMOSS-Team/MOSS-Transcribe-Diarize(复旦开源,0.9B,约 1.8GB,Apache-2.0)。国内从 ModelScope 下载:OpenMOSS/MOSS-Transcribe-Diarize,下载后校验 sha256。
- 推理栈:vLLM 0.28 官方 Docker 镜像(0.27.1 以上才认这个模型),容器里补装 librosa 和 soundfile。
- 启动参数:
  --kv-cache-memory-bytes 8589934592(8GiB,显式给字节数;统一内存的机器不要用 --gpu-memory-utilization 让它自己算,同一配置两次会算出不一样的数)
  --max-model-len 72000
  --max-num-seqs 2 --max-num-batched-tokens 16384
  环境变量放开音频上限(默认 25MB / 600 秒,长录音必挂):
  VLLM_MAX_AUDIO_CLIP_FILESIZE_MB=500
  VLLM_MAX_AUDIO_DECODE_DURATION_S=6000
  VLLM_MAX_AUDIO_DECODE_BYTES=805306368
- 服务只绑本机或内网地址,不暴露公网。

【路线 B:Apple M 系列芯片,内存 16GB 以上】
- 先试同一个模型 MOSS-Transcribe-Diarize,用 transformers 走 MPS 跑,不用 vLLM。
- 跑不动或太慢,退到 FunASR(Paraformer-zh + fsmn-vad + ct-punc + CAM++),CPU 就能跑,快,句子碎一点但可用。

【路线 C:只有 CPU】直接用 FunASR,同路线 B 的第二条。速度慢的话,公开录音优先走云端服务,本地只留给不能出门的材料。

【转写策略,三条路线都一样,不要整段一次推理】
- 长录音先用 ffmpeg 归一成 16k 单声道 wav,按 600 秒切段,每段带热词(逗号分隔,20 到 30 个);路线 A 可以 2 路并发。
- 各段的说话人标签用 CAM++ 声纹模型(ModelScope 上有,28MB)跨段对齐:每个段内说话人取不超过 40 秒音频出声纹,逐段匹配,阈值 0.55。
- 超过 60 分钟的多人录音整段推理会丢时间戳,所以一律走分段。

【怎么调用】
- 只有一台电脑:做成一条本机命令就行,比如 transcribe <音频> [热词],不用起 HTTP 服务。
- 有单独的机器:在那台机器上包成一个 OpenAI 兼容的 HTTP 接口,只对内网开放:POST /v1/audio/transcriptions(multipart 字段 file、prompt=热词、response_format=verbose_json,返回 text、duration、segments,每段 start、end、text、speaker),另给 GET /health 报状态。

【输出文件】transcript.md(按说话人合并、带时间戳的可读稿,头部列各说话人时长)和 segments.json。

【验收】拿一段 5 分钟的两人对话试跑,能出 S01、S02 交替和时间戳就算通。
装完就是一个常驻服务。我这边实测,55 分钟的录音大约 5 分钟出字,3 个半小时的大约 15 分钟。Mac 和 CPU 会慢不少,把它放着跑就行。
04 · 再加一个技能,以后音频丢进去就自动跑
服务装好以后,每次还要自己写请求太麻烦。我让 AI 给自己写了一个技能,以后我说「转文字」,它自己去跑。思路就三步,也可以直接复制给你的 AI:
技能说明 · 整段复制给你的 AI
【技能名】audio-transcribe

【什么时候用】我给你一个音频文件(wav、mp3、m4a)说「转文字」的时候。

【先判断】转写服务装在本机,还是另一台机器上。装在本机就走「本机」,装在别的机器就走「远程」。以后每次都按这个走,不用再问我。

【本机】
1. 直接调用本机的转写命令:transcribe <音频> <热词>。
2. 等它跑完,长录音要几分钟到十几分钟,别中途放弃。

【远程】
1. 先 GET http://<转写机器>:<端口>/health 看引擎状态。没起就 POST /warmup,等它 ready。
2. 把整个文件 POST 到 /v1/audio/transcriptions,multipart 字段:file=文件,prompt=热词(逗号分隔),response_format=verbose_json。超时设到小时级。

【两种都一样的收尾】
拿回 segments,在音频同目录存两个文件:transcript.md(每行「[分:秒] 说话人:文本」,同一说话人连续的合并)和 segments.json(原样存)。

【热词】默认带上这份清单,每次可以追加:(在这里写你常用的人名、产品名、法律术语)

【降级】服务连不上或跑失败,直接告诉我,不要自己换成云端服务。
热词那一栏值得认真填。当事人姓名、你常提的产品名、所里的术语,填进去以后英文名词和生僻人名基本就不错了。
装一次 以后说一句话的事
05 · 三条路出来的都是初稿
不管哪条路,出来的稿子里人名、专有名词、案由这类东西都会错一些。听悟和卡片没有热词,错得更多一点。
所以我的用法固定是两步:先拿免费的出一份初稿,然后把初稿丢给自己的 AI,告诉它这是哪场会、谁在讲、涉及哪些人和产品,让它对着这些背景清洗一遍。出来的才是能用的版本。
这套两步有人做成了开源技能,音频丢进去,初稿和清洗一起跑完。有需要的自己搜一下。
免费的出初稿 自己的 AI 洗成稿
06 · 两句实务提醒
一是前面说过的,涉及客户、案子、公司内部的录音不上云。公开讲座、课程、论坛随便。
二是录音前打个招呼。一对一的谈话,说一句「我录个音回头整理」,这个习惯比任何工具都重要。
转成字只是第一步。稿子出来了,真正值钱的是你接下来对着它说的那十来分钟。
你手机里现在躺着几段录了没转的录音?
原文发布于「零代码法律人」。读者可前往 微信公众号阅读原文。