律所能训练自己的 AI 吗?对一半
TL;DR · 一句话把所里的文书喂给 AI,就能训出懂你们所的 AI 律师?对一半。7 分钟视频,加五个要点。
▸ 这里原文有一段 7 分 15 秒视频,点这里去公众号原文看
把所里这些年的文书都喂给 AI,它就成了懂你们所的 AI 律师?对一半。
我现在在律所负责 AI 这块。这条视频拿智谱 10 月 12 日发的法律模型当例子,问三个「能不能」:大厂怎么训,律所能不能照着训,我家一张 5090 能不能训。不方便开声音的,看下面五点。
01 · 先分清四个词
预训练是读书:把整个图书馆加上大半个互联网读一遍,规律压进几百亿个数字里。后训练是上岗培训:先看示范答案,再让考官打分,学会当助理。
模型交到我们手里,按自己的需要再加练,叫微调。整本书都改一遍太贵,LoRA 的办法是书不动,只贴便利贴,论文里要训练的数字少了一万倍。
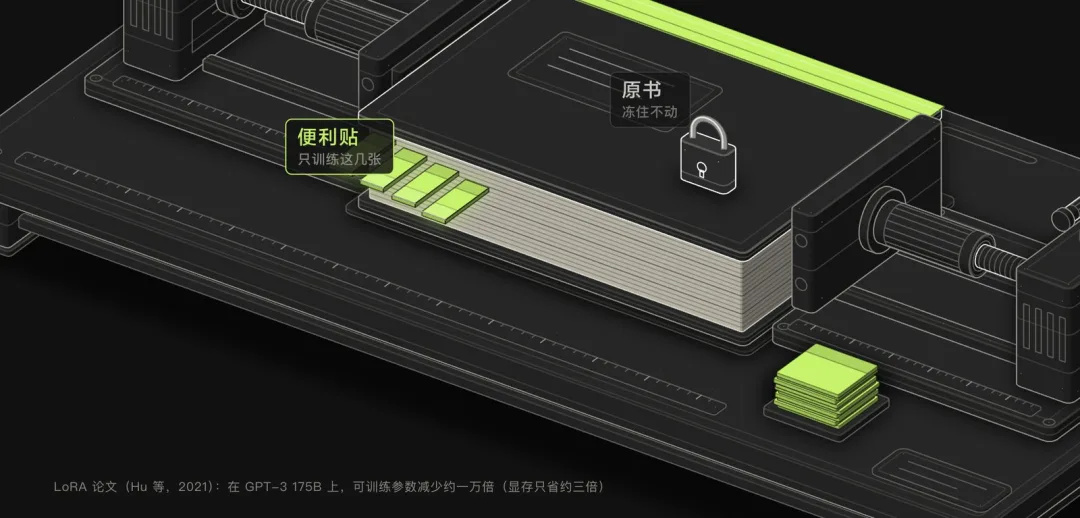
LoRA:原书冻住不动,只训练便利贴
02 · 大厂怎么训:加课
市面上的法律大模型,几乎都不是从零造的,是在通用模型上加课。
智谱的 GLM-Legal,底座是自家的通用模型,没换更大的,先多读一批法律资料,再扔进几万个贴近实战的法律场景里练。第三方 Vals 拿 Harvey 出的律师任务评测考它,通过率从 6.7% 涨到 19.2%,将近三倍。
19.2 听着不高?那是全过率:一个任务几十条要求,错一条整题算零。单看每一条,它过了九成二。不过加课也会偏科,查法律资料那张榜,它比没加课的底座还低一截。
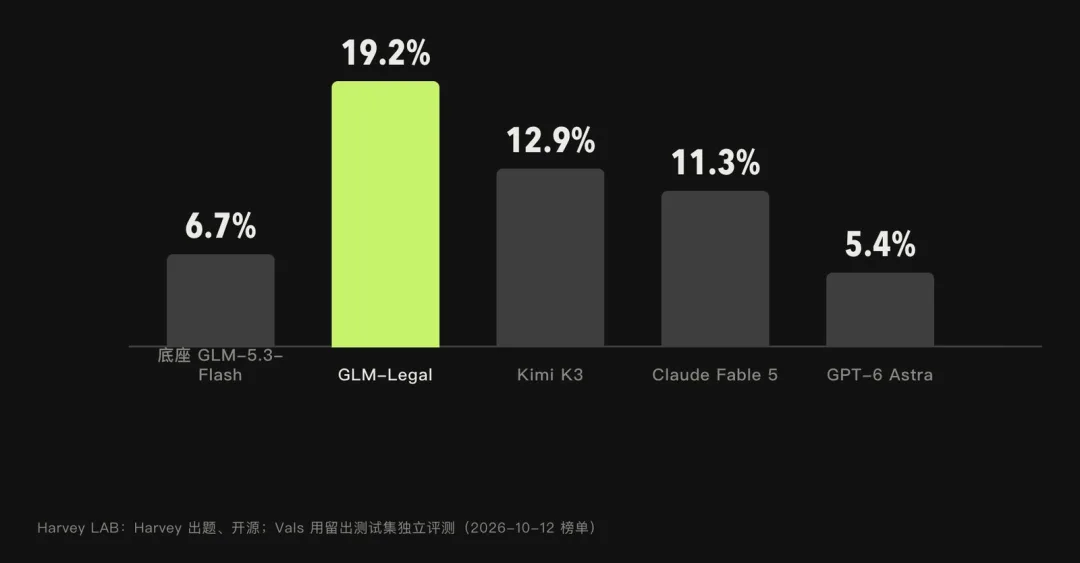
Harvey LAB 全过率,Vals 独立评测(10-12 榜单)
03 · 对的一半:怎么答
格式、口吻、你们所习惯的结构,都能教。有篇论文只用了一千条问答,就把模型调成了像样的助手。
微调教得会的,是「怎么答」
04 · 错的一半:知识和数据
知识很难靠微调学会。硬往里灌新知识,学得慢,学会了还更爱胡编。办过的案子、最新的法条,交给知识库,答题前先翻资料,相当于开卷考试。
数据也是个坎。案卷原件里到处是当事人的信息,律师法有保密义务,个人信息保护法也管着。改个名字、遮掉身份证号,在法律上一般还算个人信息;要认不出、也还原不了,才不算。照我看,案子的经过本身,往往就能认出人。真正干净的,是所里自己写的模板、写作规范,和处理干净的文书。
所以我的看法是:律所先建知识库;写法先写成一本手册给它看,不够再微调。
我的排序:知识库 → 写作手册 → 微调
05 · 一张 5090 行不行
27B 的模型整本重训,按论文口径估算要 430G 左右,5090 才 32G。普通 LoRA 也要五六十 G,照样塞不下。
先把书缩印成小开本再贴便利贴,叫 QLoRA,训练工具官方文档写的最低要求是 22G:塞得进去,但顶着天花板。数据一百到一千条就能起步。
换成一台四卡工作站,四张专业卡加起来 384G:贴便利贴一张卡就够;整本重训,还差四十多 G。门槛卡在显存,不在时间。
这一段是按官方文档和论文算的账,还没在家里实际跑过。
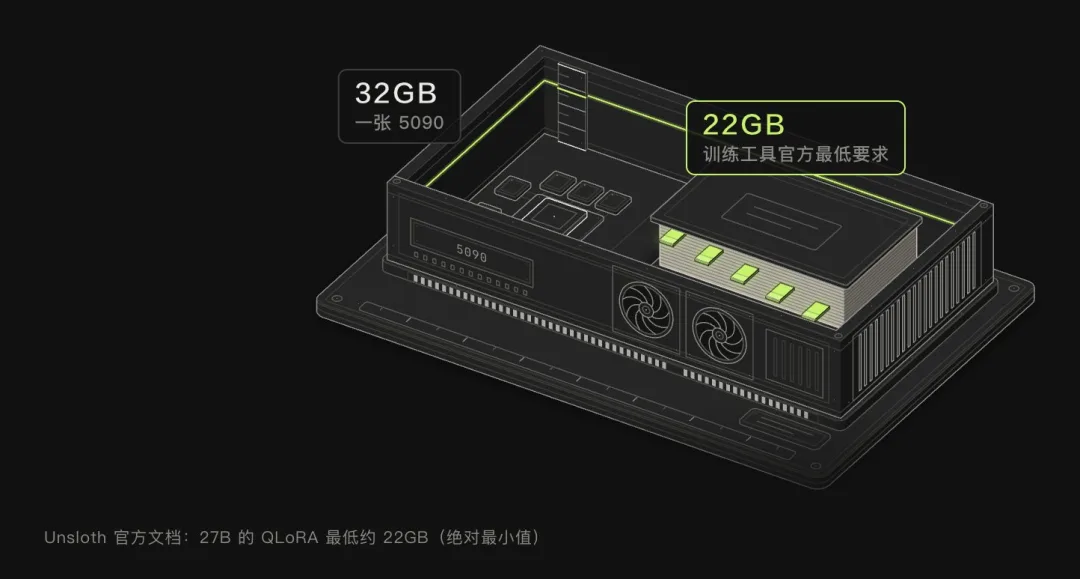
27B 用 QLoRA,官方最低约 22GB
大厂读书,律所教规矩,我这张卡,教手感。至于知识,交给知识库。
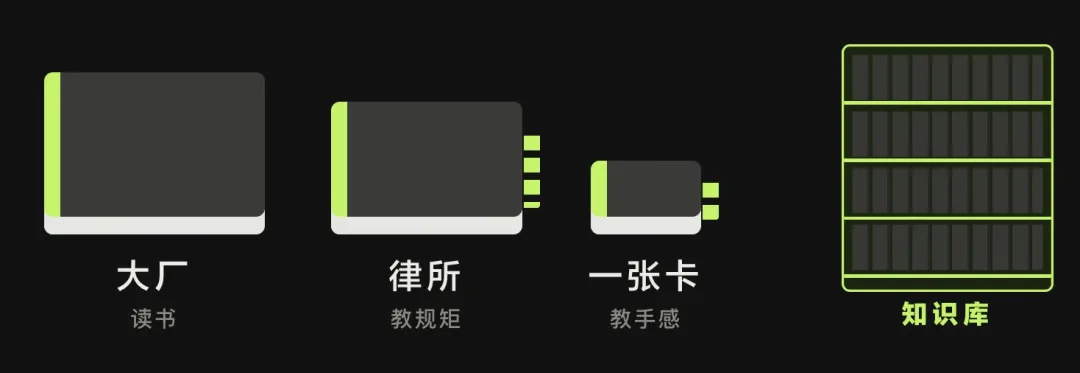
三本书,加一个书架
这是律所养 AI 系列第 1 篇。下一篇说说:新模型三天两头发布,每次都甩一张评分表,那张表怎么看。
你们所的文书,敢拿去喂 AI 吗?留言说说。
数据来源:智谱官方博客、Vals 评测页、Harvey 官方博客,LoRA、QLoRA、LIMA 等论文,训练工具 Unsloth 官方文档,个人信息保护法。显存数字按公开数据估算。视频配音为 AI 克隆本人声音。
原文发布于「零代码法律人」。读者可前往 微信公众号阅读原文。