律师出题,AI 判卷:法律 AI 的分是怎么来的
TL;DR · 一句话同一个法律模型,按条算 92.5%,一条不差只有 19.2%。律师出题,AI 判卷:7 分钟视频,加五个要点。
▸ 这里原文有一段 7 分 12 秒视频,点这里去公众号原文看
一个法律模型,考了 19.2%。题是谁出的?卷是谁判的?一句话:律师出题,AI 判卷。
我是律师,现在在律所负责 AI 这块,最常被问的就是:哪个 AI 最懂法?这条视频拆开一张考卷,看看题怎么出、卷谁来判、分怎么算。不方便开声音的,看下面五点。
01 · 律师出题,AI 判卷
拿 Harvey 出的那套法律卷子说:每道题是一份真活,从律师办过的真案子改来,案卷换成虚构的;律师事先写好五六十条必须做到的点(按公开题库估算),一条一条只判过或不过。
打勾的,是两个 AI 评委,各判一遍取平均。研究里,AI 评委跟专家的一致率,和专家之间大致相当;也有研究发现,它偏爱长答案、偏爱自家模型。能用,但分数里带着评委的误差。
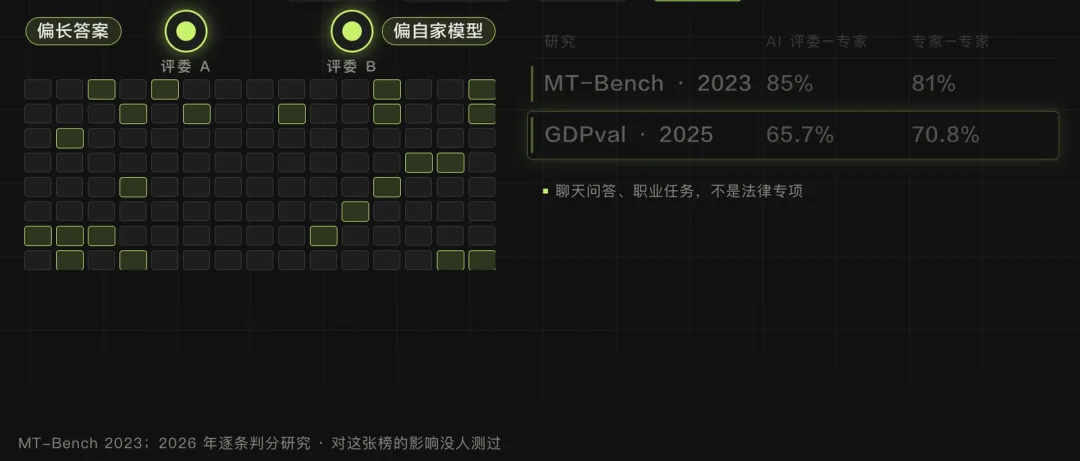
两位 AI 评委;一致率来自聊天问答、职业任务的研究,不是法律专项
0292.5 还是 19.2
智谱的 GLM-Legal 考这张卷子,按条算过了 92.5%,一条不差的题只有 19.2%。假如错误是随手撒的,整题全对大概只有 1%(估算);实际有 19%,说明错误多半是成串的:漏看一份合同,那份合同底下一串评分点一起挂。
Harvey 自己也讲:十个风险找出八个,不是八十分,是报告不完整。一个算的是分,一个算的是这活能不能交。
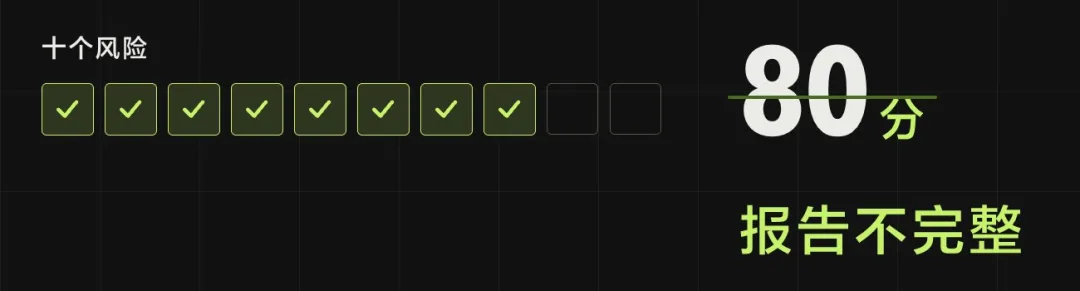
十个风险找出八个,不是 80 分
这个分还自带误差,算下来上下大概四道题。榜上第六名和第七名只差半道题,也就是一位评委的一次判断。靠前几位,常常是同一档。
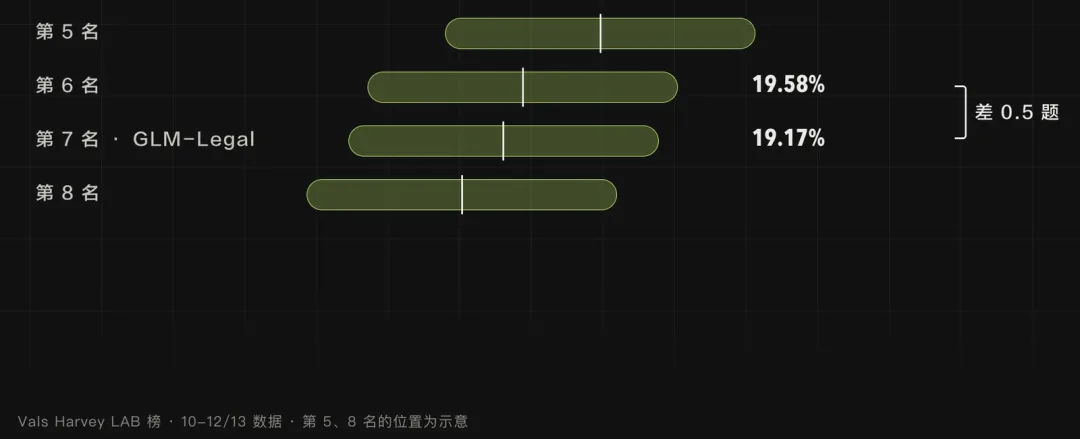
Vals 的 Harvey LAB 榜(10-12/13 数据),第 5、8 名位置为示意
03 · 律师该看哪张卷子
第三方 Vals 跑的三张法律卷子,选择题那张榜首八十多分,查资料五十多,交成果只有二十多。口径不同,只看趋势:越像真活,分越低。
查法条、读案卷、写文书,英美法都有像样的卷子;听懂委托人到底要什么,还没有一张卷子专门在考。中国法论文题库不少,可没有持续更新的公开榜。我的看法:英美的榜可以拿来挑底座模型,不能当它懂中国法的证明。
还有一层:榜单测的多是模型,律师买的是产品。斯坦福 2024 年测过几款法律检索产品,编造或说错的,好的大约六题一题,差的三题一题。
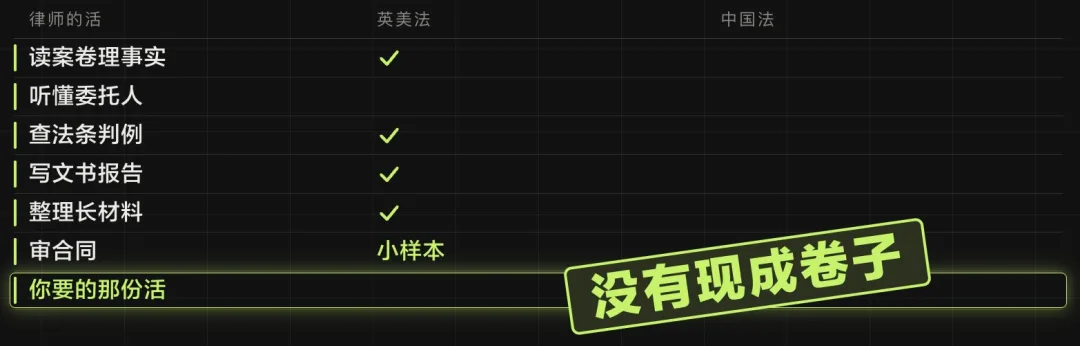
没有一张现成的卷子,考的是你要的那份活
04 · 出题,是门生意
招律师出题判卷的,大多不是律所,是外包平台、法律科技公司、大模型公司。有个招聘平台今年 8 月招过人写中国法选择题,一小时四五十美元,现在已经不收人了。
为什么出题能赚钱?一套题能用两次:一次当考卷,一次当练习题,评分点一条条变成奖励,让模型反复练。Harvey 和智谱都公开讲过这么用。
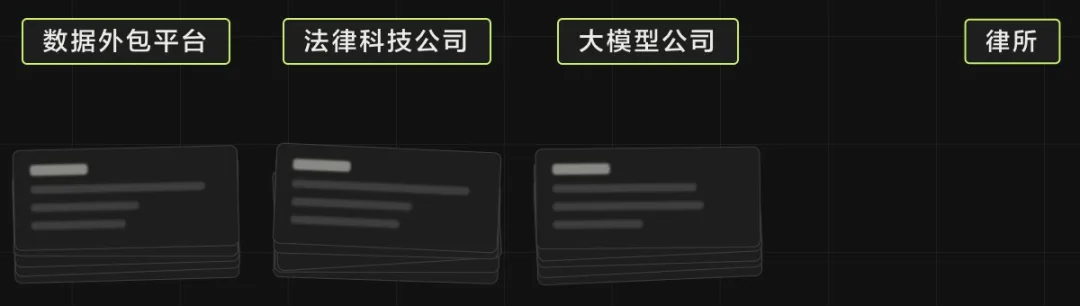
招律师出题的,大多不是律所
05 · 律所能自己出卷吗
能,国外大所做过:英国一家出了五十道题,澳洲一家出了三十道,都请资深律师打分。
照这些先例我归纳了一下,靠谱的榜至少要七样:题从真活来且不公开;律师写评分点;写清测的是模型还是产品;律师盲评,再拿 AI 评委对照;题量够;写清版本和跑法;定期换题。
题量最容易低估:三十道题只看得出二三十分的大差距,两家二选一,同一套题大概要一百五到两百五十道(估算)。国内十月刚有一份法律 AI 评测团体标准在征求意见,也写了:法律专业判断,不能只凭机器打分。
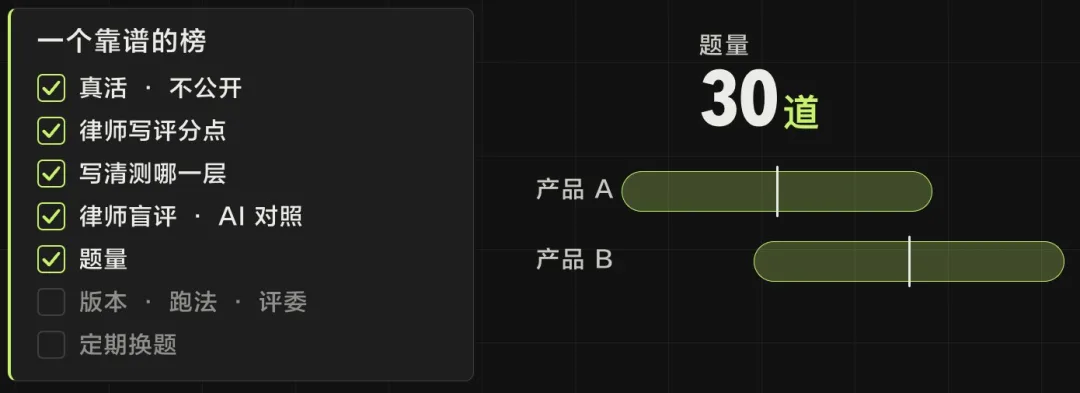
一个靠谱的榜,至少这七样(我的归纳)
看分数前,先问三句:考什么题,谁判卷,分怎么算。最该信的那张卷子,是你自己出的。
这是律所养 AI 系列第 3 篇。下一篇:我自己出了一套题,考了四个模型。
AI 判的卷,你信几分?留言说说。
数据来源:Harvey 官方博客与评测说明、Vals 评测页(10-12/13 数据)、智谱官方博客,MT-Bench、GDPval 等论文,斯坦福 2024 年法律检索产品研究,英国、澳洲两家律所公开的评测页,法律 AI 评测团体标准征求意见稿。题量、误差、「大概 1%」等按公开数据估算。视频配音为 AI 克隆本人声音。
原文发布于「零代码法律人」。读者可前往 微信公众号阅读原文。