内存出厂价一个季度涨了九成多,AI 为什么这么吃内存?
TL;DR · 一句话推手是 AI:它每说一个字,都要把整个模型从头读一遍。五件事讲清:内存和显存、涨价、吃内存、英伟达还是苹果、CUDA。
内存今年贵得离谱。
按 TrendForce 的统计,今年一季度,内存的出厂价,也就是内存厂和大客户之间签的合同价,一个季度就涨了九成多。
推手是 AI。
那 AI 凭什么这么吃内存?答案就一句话:它每说一个字,都要把整个模型从头读一遍。
后面所有事,内存为什么涨价、显存为什么金贵、英伟达和苹果谁更适合跑模型,都是从这句话来的。
我家里有三台能跑大模型的机器。其中那台盒子,我一直拿它试一件事:律所能不能把模型放在本地跑,客户材料不出门。拿三台一比,结果有点出乎意料:内存最大的那台 128G 盒子,说话速度和我 2023 年的 MacBook 是一个档次。
为了把这件事搞明白,我做了一条视频,6 分多钟。
▸ 这里原文有一段 6 分 38 秒科普视频,点这里去公众号原文看
不方便开声音的,下面是文字版。拆成五件事,一件一件说。
01 · 内存和显存,到底差在哪
其实是同一类芯片。差别只在两件事:离干活的芯片多近,路有多宽。
电脑的内存条插在主板上,离处理器好几厘米,中间就两条道。
显卡不一样,显存一颗一颗,就焊在显卡芯片四周,贴身围了一圈。路宽了 4 倍,每条道上还跑得快 5 倍。乘起来,显卡搬数据比电脑内存快二十倍左右:电脑内存每秒约 90G,最顶级的游戏显卡 RTX 5090,每秒 1792G。
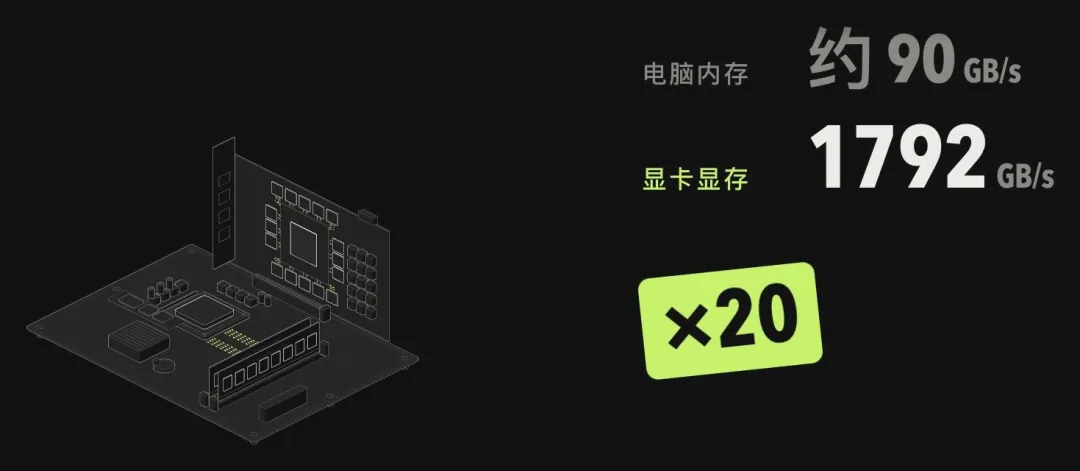
同一类芯片,显卡显存搬数据快二十倍左右
数据中心的 AI 显卡更狠,显存直接叠成楼,贴在芯片旁边,叫 HBM。英伟达的 B300,一张卡每秒能搬 8T。
代价也很明显:显存小、贵,焊死了不能加。电脑插个 64G 内存不稀奇,最顶级的游戏显卡,才 32G。
放不下怎么办?挤到电脑内存里,数据就要在内存和显卡之间过一座桥。这座桥每秒才 60 多 G,比内存自己还慢。所以玩本地模型的人都在拼命想一件事:把整个模型塞进显存。
显存不是更大 是更快
02 · 内存为什么突然这么贵
做内存的基本就三家:三星、SK 海力士、美光。按今年一季度的营收算,三家加起来占了快九成。
今年,三家都把产线优先给了 AI:一是刚才说的 HBM,二是数据中心的服务器内存。这两样加起来,占了今年内存产量的一半左右(按容量算)。
HBM 还特别费料。今年它占了三大厂两成多的产能,只产出不到一成的容量。
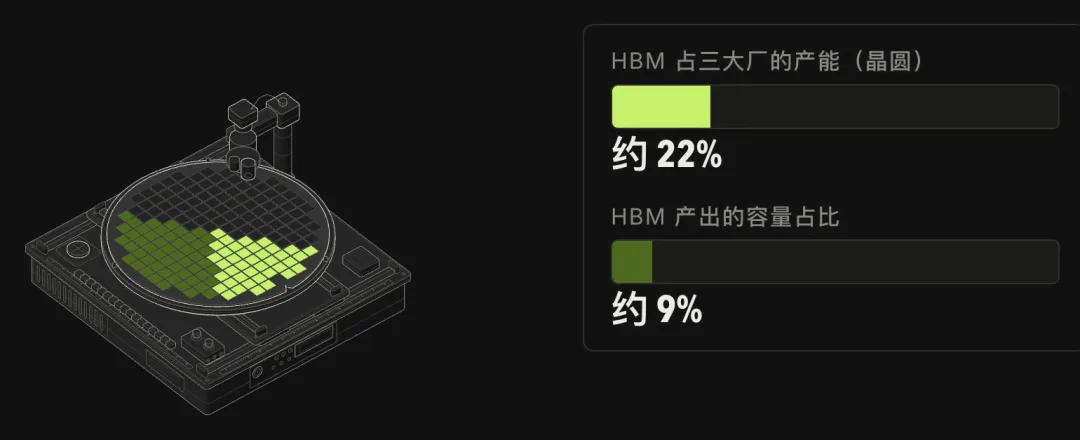
HBM 占两成多产能,只出不到一成容量(TrendForce 2026 年估计)
产量一时又上不去,今年主要靠改进老产线慢慢挤;几家大的云计算公司,又肯出高价。剩给电脑和手机的,就只能涨。
涨了多少?一季度实际涨了九成多;后面几个季度还在涨,只是一季比一季慢,到四季度,预估还要再涨一成多。
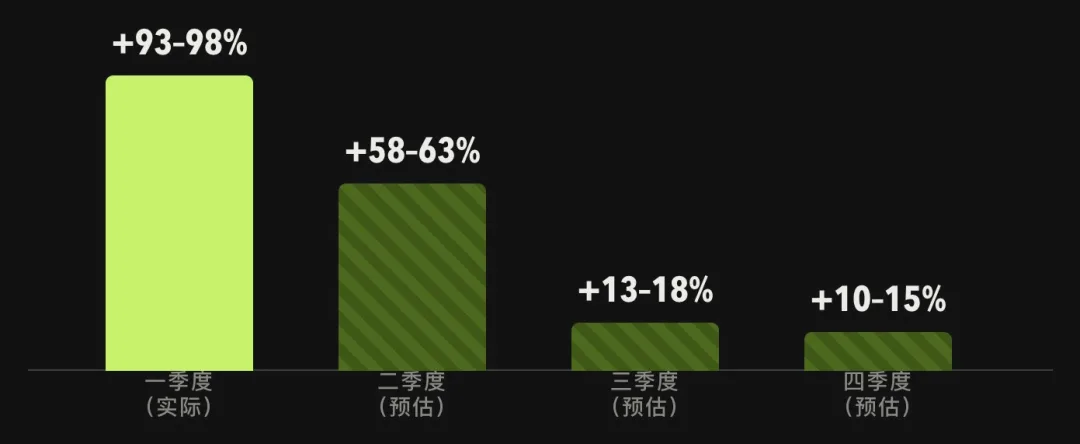
常规内存合约价,每季度比上一季度涨多少(一季度为实际,后三季为预估)
这里要说清楚:这些都是厂商之间签合同的价格,不是你在电商买内存条的价格。零售价涨了几倍,媒体的说法从三倍到六倍都有,型号、地区、时间点各不一样,我没找到一手数据,就不报具体数了。
03 · AI 为什么这么吃内存
一个大模型,说白了就是一本书,里面写满了几百亿个数字。
一个「70B」的模型,就是七百亿个数字。原样存下来,按公开参数估算是 140G 左右;压缩一下,也还要 40G 左右。
关键是:它每说一个字,都要把这一整本,从头读一遍。
所以它说话快不快,主要看搬得多快。这个搬运速度,就是常说的「带宽」。
算一下就明白:一本 40G 的书,放在一台每秒能搬 400G 的机器上,一秒最多读 10 遍,也就最多说 10 个字。这是理论上限,实际更慢。
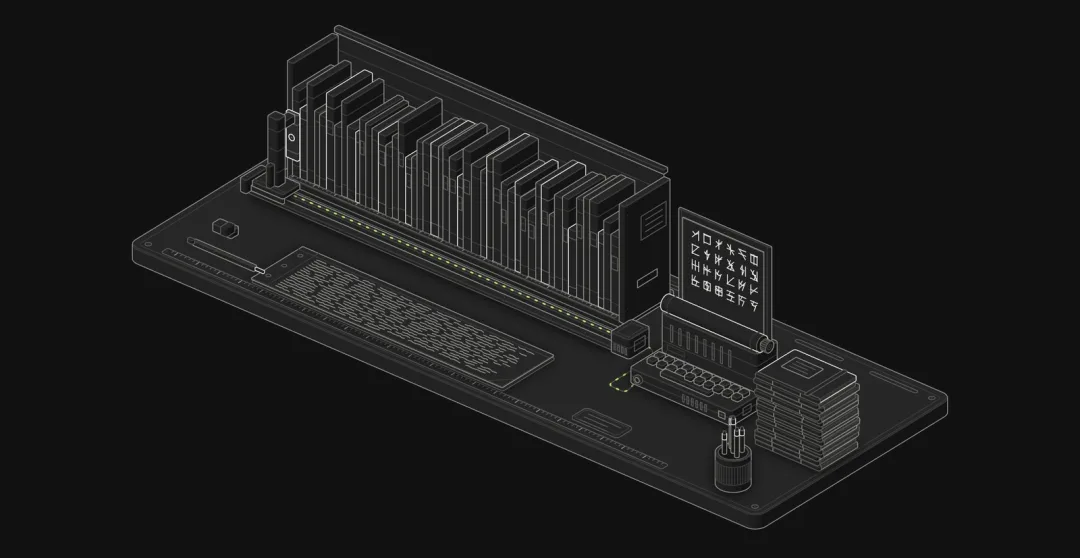
每打出一个字,读头就要把整排书架扫一遍
还没完。聊得越长,它还要给前面说过的每个字,记一份「笔记」,免得每次从头重读整段对话。
以 Meta 的 Llama 3.1 70B 为例,聊上十几万字,光笔记就要 40G,跟压缩后的模型本身一样大。
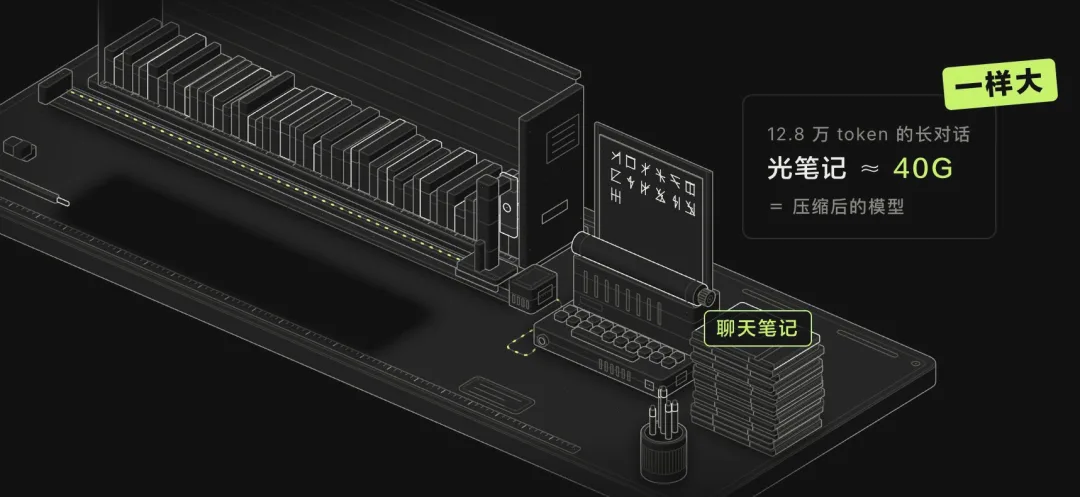
长对话的笔记,跟压缩后的模型一样大
数据中心同时伺候成千上万个人,每人都要一份笔记。AI 数据中心今年这么抢内存,这是一大原因。
现在流行的「先想再答」的模型更费。按 DeepSeek 官方的数字换算,新版 R1 做一道竞赛数学题,平均要先打一万多个英文单词的草稿。草稿也要记笔记。想得越久,越吃内存,也越慢。
04 · 本地跑大模型,英伟达还是苹果
两条路。
英伟达的显卡,就是上面说的:快,但小。
苹果走的是「统一内存」:处理器和显卡共用一大池内存,不用过桥搬来搬去。苹果 8 月发布的新 Mac Studio,顶配能配到 512G,搬运速度每秒 1.2T,已经是最顶级游戏显卡的三分之二。不过 512G 这一档,苹果说要 10 月下旬才供货。
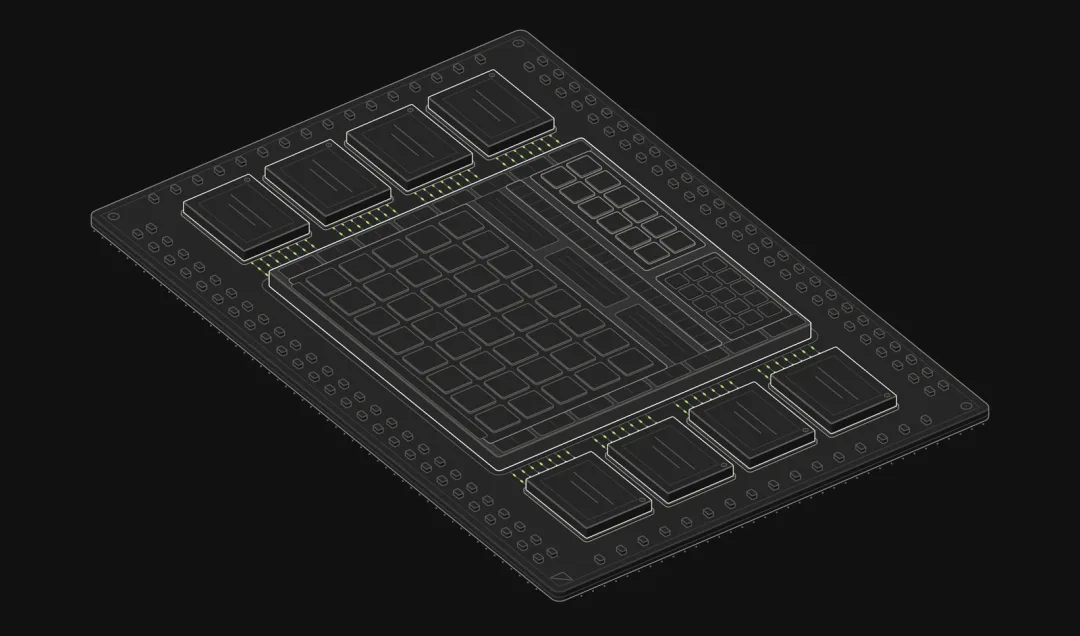
苹果芯片,处理器、显卡和内存封在一起,共用一池
英伟达自己也出了一种大内存的小盒子,芯片叫 GB10,也是一大池,128G。我家里那台就是。
那就拿家里三台机器跑同一个模型,比一比:GB10 盒子(128G)、2023 年的 MacBook Pro(36G)、RTX 5090 台式机(32G 显存),各用自己日常最好的设置。
先交代一句:这个模型每说一个字,只读其中一小部分,所以速度比上面那本 40G 的书快得多。看档次就行。
先比说话。 盒子和 MacBook,每秒几十个字;5090,每秒两百多个。因为 5090 的搬运速度,是另外两台的六倍左右。说话快慢,基本就是跟着搬运速度分档。
所以那台 128G 的盒子,内存最大,说话速度却和 MacBook 一个档次。
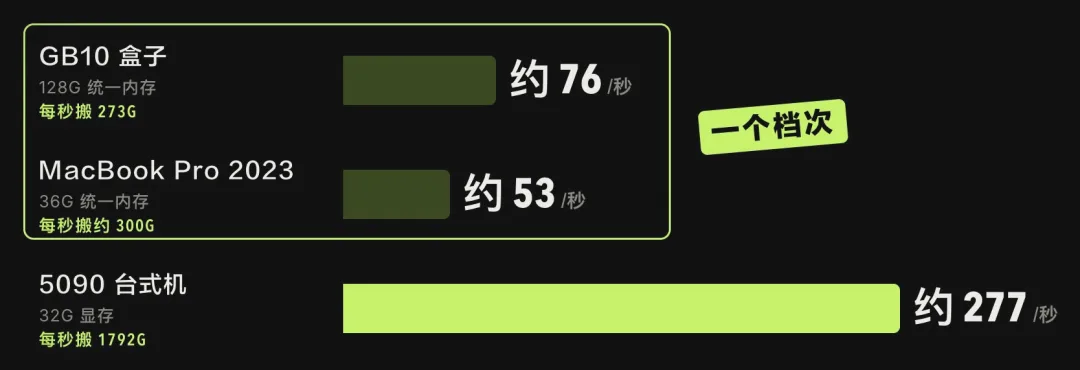
家里三台机器,同一个模型的说话速度
再比读题。 你丢一份几十页的合同进去,它开口之前,要先把整份读完。
这回反过来:两台英伟达,每秒读几千个字;MacBook,不到一千。
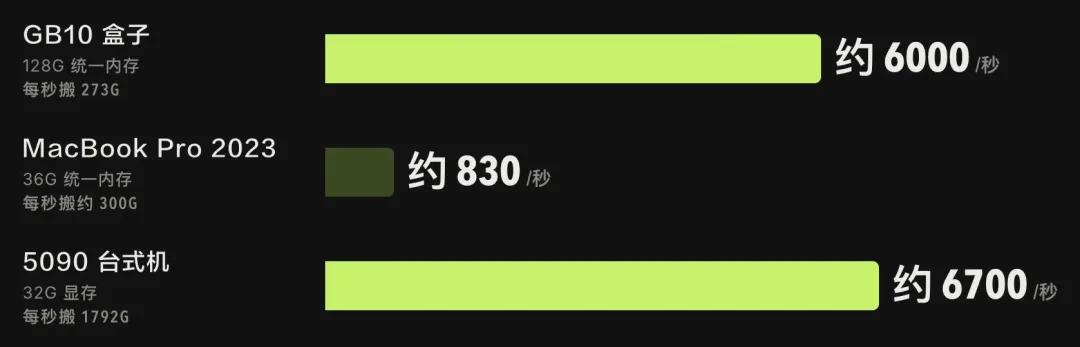
同一个模型的读题速度
读题靠算力,说话靠搬运。英伟达赢在算力,苹果赢在一大池内存。对天天跟卷宗、合同打交道的人,读题这一项其实更要紧:材料越长,每次提问前干等的时间就越长。
还真有人把两样拼起来用:国外有个团队让英伟达的盒子读题、上一代顶配 Mac Studio 说话,比单用 Mac 快了近三倍。
也要说句公道话:我这台 MacBook 是 2023 年的。苹果现在的新款,顶配 MacBook Pro 搬运速度是它的两倍,顶配 Mac Studio 是四倍,别拿我这台代表现在的 Mac。
5090 最快,可它只有 32G,连上面那本 40G 的书都装不下。
装得下,不等于跑得快 跑得快,也不一定装得下
05 · 老听人说 CUDA,它到底是啥
显卡本来是画游戏画面的。2006 年 11 月,英伟达推出 CUDA,让程序员能指挥显卡,去算别的东西。
你可以把它理解成:跟英伟达显卡说话的那套语言,外加一整箱现成的工具。
攒了快二十年,AI 软件大多先支持它。苹果有自己的一套(Metal、MLX),AMD 也有,都在追;但很多新东西,要等人搬过去。
所以说英伟达更适合跑 AI,很多时候说的不是内存,是 CUDA。
收一下,三笔账:
· 装不装得下,看容量;
· 说得快不快,看搬运;
· 读得快不快,看算力。
下回看到内存又涨价,你就知道了:是 AI 每说一个字,都在把自己从头读一遍。
你现在用什么机器跑模型?留言说说。
原文发布于「零代码法律人」。读者可前往 微信公众号阅读原文。